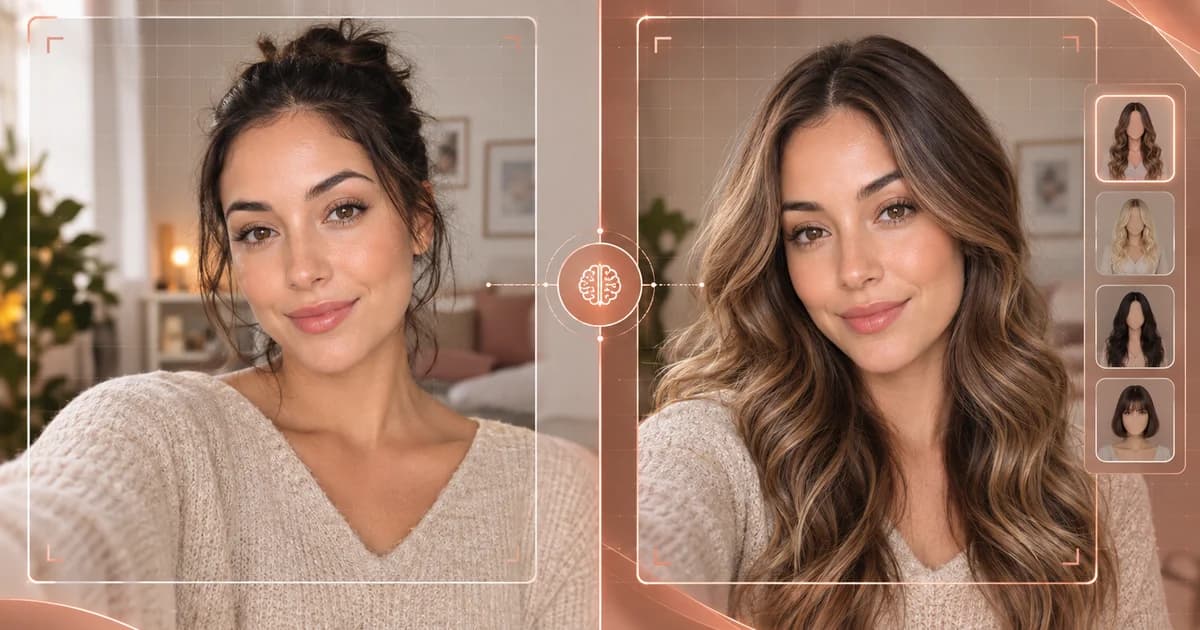
自撮りをアップロードすると、試したことのないウィッグを着けた自分が見える — 魔法のようです。しかしそのabout 20 secondsの待ち時間の裏では、それぞれが一つの役割を担うAI技術が綿密に連携しています。
この記事では、AIバーチャルウィッグ試着がどう動くか — 写真を選んだ瞬間から結果が表示されるまで — を、専門用語に頼らず、ステップごとに解説します。
AI試着が解決する問題
オンラインでウィッグを買うのは賭けです。50〜500ドル以上を、自分の顔で一度も見ていないものに使うことになる。他のモデルのストック写真では役に立たない — 顔型、肌トーン、額の幅、あごラインは一人ひとり違う。モデルに似合っても、あなたにはまったく違って見えることがあります。
バーチャル試着は、あなたの顔にフォトリアルなプレビューを見せ、お金を使う前に判断材料を与えます。キーワードは「フォトリアル」 — 漫画フィルターでも顔スワップでもなく、髪だけが変わったフルAI生成画像です。
ステップ1:画像選択とローカル顔チェック
自撮りを選んだ時点で処理が始まります。ただし端末から出る前に、品質チェックが走ります。
ブラウザ側の顔検出
Chromium系ブラウザ(Chrome、Edge、Opera)では、ネイティブの FaceDetector APIがブラウザ内で直接実行されます:
- 画像に顔があることを確認
- 使えない写真を検出 — 顔なし、極端な角度、大きな遮蔽
- 端末内のみ — まだ写真はアップロードされていない
AIが処理できない写真で試行を無駄にしないためです。FaceDetector非対応(Firefox、Safariなど)ではこのステップをスキップし、サーバーで検証します。
良い写真の条件
すべての自撮りが良い結果になるわけではありません。AIが最も得意なのは:
| 要素 | 良い | 悪い |
|---|---|---|
| 角度 | 正面、目がカメラ | 横顔、視線外 |
| 照明 | 均一、自然光 | 強い影、逆光 |
| 生え際 | 見える、遮られていない | 帽子、ヘアバンド、厚い前髪で隠れる |
| 頭の傾き | 水平、最小限 | 極端な傾き・回転 |
| 背景 | シンプル | 髪と競合する busy パターン |
| 肩 | 見える | 首で切れる(長さ判断が難しい) |
ステップ2:クライアント側画像圧縮
アップロード前に、Canvas APIでブラウザ内圧縮。実用的な最適化です:
- 長辺最大1536px — それ以上大きくてもAI品質は上がらない
- JPEG品質85% — 見た目は同じでファイルは大幅に小さく
- 典型的な削減:4MBのスマホ写真が約200KBに
なぜ重要か
- アップロードが速い — モバイル回線で特に
- データ使用量が少ない — 容量制限のあるプラン向け
- AI品質は同じ — 1200万画素入力でも生成モデルは恩恵が少ない
- すべてブラウザ内 — フル解像度の原本は端末から出ない
ステップ3:安全なアップロードと保存
圧縮後、暗号化クラウドストレージへ:
- AWS S3上のAES-256サーバー側暗号化
- プリサインドURLアップロード — アプリサーバーを経由せずストレージへ直接
- 24時間S3ライフサイクルルール — ファイルは自動的に永久削除
意図的な設計です。プレビュー生成後に写真は不要なので、保持しません。
ステップ4:AIプロンプト構築
ここから「知能」の部分。AIは写真を見るだけでなく、何をすべきかを正確に述べた指示を受け取ります。
プロンプトの内容
- アップロードした自撮り — ソース画像
- スタイル説明 — 「この人の髪を、あご丈のブラントボブ、きれいでシャープなラインに変更」
- 色説明 — 「ハニーブロンド色で」
- 保持指示 — 「顔、肌トーン、表情、服、背景は完全に同じ。変更するのは髪のみ。」
プロンプトエンジニアリングが重要な理由
プロンプトの質が結果の質に直結。「ボブにして」では一貫性が出にくい。長さ、質感、色、保持を具体的に書いたプロンプトは、本人らしいフォトリアル画像を生みます — 髪だけが違う。
肌トーン、顔型、髪質ごとに数百のプロンプトバリエーションをテスト・改善し、一貫して機能する formulation を見つけています。
ステップ5:画像to画像AI生成
プロンプトと写真が image-to-image AIモデルへ。コア技術で、最も計算コストが高いステップです。
画像to画像生成の仕組み
テキストto画像(ゼロから生成)と違い、既存写真を指示に従って修正。変えない部分(顔)を保ちつつ、変える部分(髪)を変換できるのが強み。
モデルは**拡散(diffusion)**で動作:
- 写真を数学的表現(「潜在空間」)にエンコード
- 髪領域に制御されたノイズを適用
- スタイル/色の説明に従ってその領域を「デノイズ」
- 結果をピクセル画像にデコード
顔の幾何、肌トーン、照明、背景を保ちつつ、説明されたスタイル・色の新しい髪を生成 — 1パスで最終結果をabout 20 secondsで出力。
マルチモデルアーキテクチャ
Wigwyは複数AIプロバイダーとインテリジェントルーティング:
- プライマリモデル(品質対コスト最適化)
- プライマリ不可時のフォールバック
- 一時的失敗時の自動リトライ
単一プロバイダーの稼働に左右されず、可用性と品質を維持。
ステップ6:結果配信と品質
生成画像がブラウザに返る。見えるのは、選んだスタイルと色を着けた自分の高解像度写真です。
結果でできること
- 並べて比較 — 元写真と結果
- 別スタイルを試す — スタイルや色を変えて新プレビュー
- ギャラリー保存 — お気に入りを後で比較(サインイン必要)
- 共有 — 友人やスタイリストへユニーク共有リンク
- ダウンロード — 端末に保存(有料トライは透かしなし)
AIの限界を理解する
AI生成は強力ですが完璧ではありません。期待値:
- 生え際の精度 — 自然な生え際と額の境界は近似。特定レースフロントの生え際を完全再現はしない。
- 質感の細部 — 全体の質感(ストレート、ウェーブ、カール)は正確だが、一本一本の毛の細部は実物ウィッグと異なることがある。
- 色の精度 — 色の方向は正しいが、正確な色合いは画面のキャリブレーション依存。
- 一貫性 — 同じ写真・スタイルでも2回でわずかに異なる結果があり得る。拡散モデルでは正常。
プライバシーアーキテクチャ:データ保護
プライバシーは後付け機能ではなく、システム全体を縛る制約として設計しました。
データライフサイクル
- アップロード:転送中TLS、保存時AES-256(S3)
- 処理:プレビュー生成のためのみアクセス、その後アクセス権失効
- 保存:24時間S3ライフサイクルで自動削除
- 学習:写真はAIモデル学習に使用しない — 自社もプロバイダーも
BIPAコンプライアンス
イリノイ州生体情報プライバシー法(BIPA)は、生体データ処理前の明示的同意を要求。Wigwyは:
- アップロード前に informed consent
- 同意記録を法定5年保持
- 明確なデータ削除経路
- 生体データの販売・共有なし
行わないこと
- ❌ 24時間超の写真保存
- ❌ AIモデル学習への写真利用
- ❌ 他ユーザーへの写真共有(共有リンク作成時を除く)
- ❌ 初回試着のためのクレジットカード要求
- ❌ 不要な個人情報収集
よくある質問
バーチャル試着はどのくらいかかる?
アップロードから結果まで全体でabout 20 seconds。大半はAI画像生成。圧縮とアップロードは通常回線で1〜3秒。
すべてのスマホで動く?
はい。WigwyはモダンWebブラウザで動作 — アプリ不要。ローカル顔検出はChromium系(Chrome、Edge);他ブラウザはこのステップをスキップ。
なぜ結果が毎回少し違って見えることがある?
拡散モデルは本質的に確率的 — 生成中に制御されたランダム性を入れる。同じ写真・スタイルでも2回で細部がわずかに異なることがある。スタイルと色は正しいが、毛の配置などの細部は変わり得る。
AIは改善し続けている?
新しいAIモデルとプロンプトを継続テスト。改善が見つかれば全ユーザーに展開。マルチモデル構成でダウンタイムなしに better モデルを採用可能。
スタイリストに欲しいスタイルを見せられる?
はい。結果を保存またはスクショしてウィッグ専門家や美容師と共有。言葉で説明するよりはるかに有用なコミュニケーションツール。
自分で試す
技術を体験したい?Wigwyを無料で試す — 無料アカウントを作成し、自撮りをアップロードしてabout 20 secondsでフォトリアルなウィッグプレビュー。初回試着は無料。
先にカタログを見る?9カテゴリ60以上のスタイルを参照。